ÍNDICE DE LEITURA
Excesso de estoque e ruptura coexistindo na mesma operação. Se isso soa familiar, o problema provavelmente não está na ausência de previsão, mas em como ela está sendo lida.
A maioria das operações já tem dados, modelos e métricas acompanhadas. Mesmo assim, o planejamento continua instável, com ajustes manuais frequentes e o mesmo ciclo de erro se repetindo mês a mês.
O erro de previsão de demanda, na prática, está concentrado em um grupo pequeno de produtos, que distorcem o resultado inteiro enquanto ficam escondidos atrás de médias aparentemente aceitáveis.
Identificar esses SKUs problemáticos é o que separa uma operação que persegue a acurácia média daquela que realmente decide melhor. É por isso que preparamos esse conteúdo para te ajudar a desvendar quais são eles e como agir para alcançar a otimização.
A armadilha da acurácia média
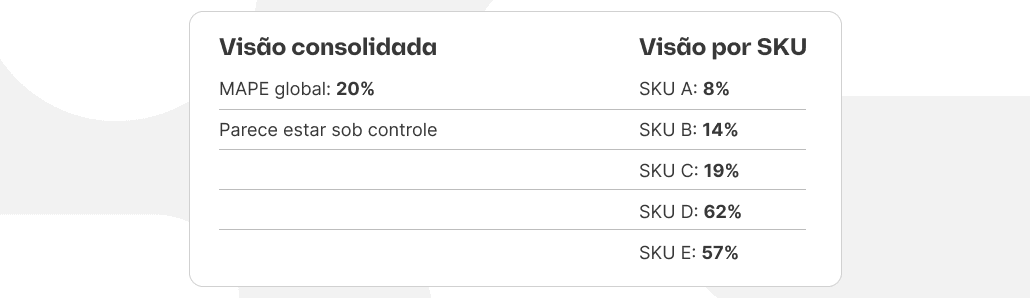
Uma operação pode apresentar MAPE global de 20% e, ao mesmo tempo, errar 60% em produtos de alto giro. Isso acontece porque a média dilui os extremos. Poucos itens com erro alto puxam o resultado para cima, mas esses mesmos itens ficam invisíveis quando a análise fica no nível agregado.
O risco disso é que a operação calibra o planejamento com base em um número que não reflete o que está acontecendo nos SKUs que mais impactam o estoque, a margem e o capital de giro. A gestão parece estar sob controle, mas o operacional, não.
A virada acontece quando a análise desce do consolidado para o produto. É nesse nível que o erro de previsão de demanda deixa de ser uma estatística e vira um mapa de onde atuar.
Quando você passa a olhar erro por SKU, começa a enxergar onde o forecast realmente falha. E, principalmente, onde isso impacta o resultado. O foco deixa de ser melhorar o número médio e passa a ser reduzir risco nos pontos críticos.
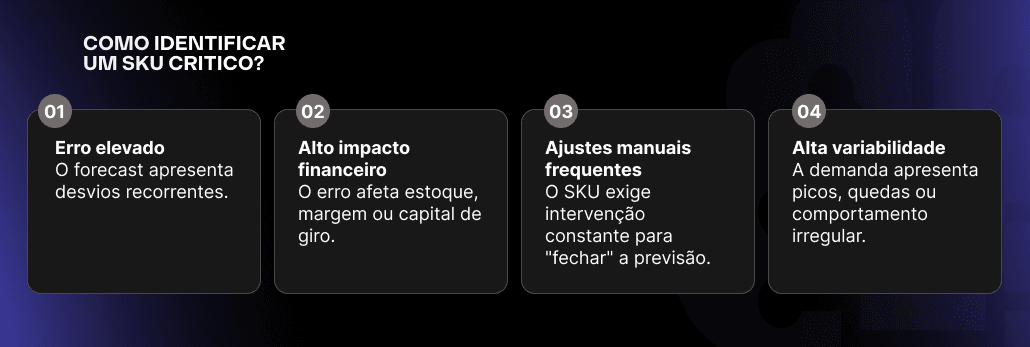
Os 4 sinais que revelam quais SKUs estão concentrando o problema
Ranking de erro por SKU
O primeiro passo é criar um ranking granular de erro por produto, não por categoria ou família. MAPE, WMAPE, RMSE: cada métrica conta uma parte da história.
O MAPE é o mais comum e o mais fácil de interpretar, mas tem limites importantes. Por exemplo, ele não funciona bem para SKUs com vendas próximas de zero e penaliza mais a subestimação do que o excesso.
O WMAPE corrige parte disso ao ponderar o erro pelo volume, priorizando produtos de maior faturamento. O RMSE é mais sensível a grandes desvios, sendo relevante quando um erro pontual tem consequências operacionais severas.
Depender de uma única métrica cria pontos cegos. O ideal é combinar pelo menos duas e checar também o BIAS. Se um SKU está consistentemente superestimado ou subestimado, o problema é estrutural no modelo, não apenas variabilidade de demanda.
O ranking de erro por SKU é o ponto de partida. Mas por si só não é suficiente para priorizar a ação.
Impacto financeiro
É quando o erro é traduzido em dinheiro que a priorização fica objetiva.
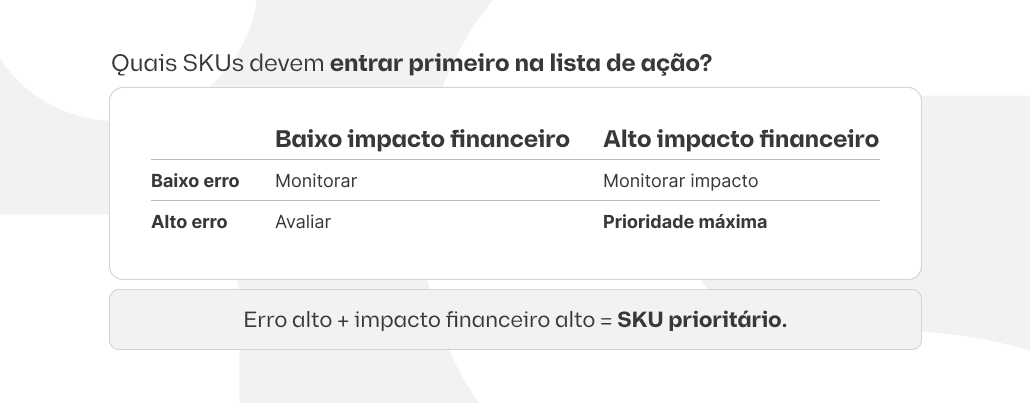
Um SKU com MAPE de 50% em um produto de baixo giro pode gerar impacto menor do que um SKU com MAPE de 20% em um item de alta margem. Isso revela que erro percentual não diz onde atuar, mas custo do erro, sim.
Todo erro de previsão de demanda se materializa em dois cenários, e ambos têm custo direto: excesso imobiliza capital e gera custo de carregamento; ruptura destrói margem e, dependendo do segmento, custa cliente.
O custo total de carregamento de estoque gira entre 20 e 30% do valor do inventário por ano, o que significa que manter R$5 milhões parados por causa de previsão ruim custa entre R$1 e R$1,5 milhão só em carregamento anual.
Do outro lado, rupturas de estoque geram, em média, 4% de vendas perdidas, podendo chegar a 7,4% em bens de consumo.
Quando você conecta o ranking de erro ao impacto financeiro por SKU, os candidatos à ação emergem com clareza. Alguns itens que pareciam críticos pelo erro percentual caem na prioridade. Outros, que passavam despercebidos, sobem para o topo da lista.
Frequência de ajustes manuais
SKUs que exigem intervenção constante são um sinal de que o modelo não está capturando o comportamento da demanda. Não é culpa do analista, mas o sintoma de um produto que o sistema não sabe prever.
O problema vai além da ineficiência operacional. Ajustes manuais frequentes tendem a introduzir viés sistemático. A tendência de ajustar para cima em períodos de pressão comercial, por exemplo, cria uma superestimação consistente que o modelo absorve como padrão e amplifica nas próximas rodadas.
Há um padrão que se repete: os SKUs mais ajustados são, muitas vezes, os que continuam com maior erro residual. Isso cria um ciclo de baixa confiança no modelo, mais intervenção manual e piora progressiva da acurácia. Monitorar a frequência e o impacto dos ajustes manuais por SKU quebra esse ciclo ao tornar o problema visível antes que ele se normalize.
Variabilidade de demanda
Nem todo produto tem o mesmo comportamento de demanda. Por isso, tratar todos com a mesma abordagem é uma das fontes mais silenciosas de erro de previsão de demanda em operações que já têm boas ferramentas.
Produtos estáveis respondem bem a modelos tradicionais. Mas uma parte relevante de qualquer portfólio apresenta comportamento errático, como picos sem padrão, quedas abruptas, sazonalidade irregular. Para esses itens, o problema não é o modelo estar mal calibrado e, sim, estar errado para o tipo de comportamento que o produto apresenta.
O Coeficiente de Variação (CV) é a métrica mais direta para mapear isso. Um CV acima de 1 indica demanda muito instável, e, nesses casos, a solução não passa só por afinar a previsão. É preciso repensar a política de estoque, o nível de segurança e, em alguns casos, a própria estratégia de abastecimento.
Identificar quais SKUs têm alta variabilidade é o que permite diferenciar a abordagem: produtos estáveis num modelo, produtos erráticos noutro, e itens de alta margem com tratamento dedicado no S&OP.
O que fazer com esses SKUs
Identificar os SKUs problemáticos é metade do caminho. A outra metade é tratar cada categoria de forma diferente.
Para SKUs com erro alto e impacto financeiro relevante, o tratamento passa pelo S&OP. Esses produtos precisam de atenção explícita, com inteligência de mercado integrada à análise estatística e critérios claros de quando o ajuste manual faz sentido ou quando ele só adiciona ruído.
Para SKUs de alta variabilidade, a resposta é adaptar o modelo ao comportamento da demanda, não forçar previsibilidade onde ela não existe. Modelos específicos para demanda intermitente, revisão das políticas de estoque de segurança e, em alguns casos, racionalização de portfólio: quando dois SKUs parecidos canibalizam a mesma demanda, descontinuar um pode reduzir a variabilidade e melhorar a previsão do que fica.
Para SKUs com alta frequência de ajuste manual, troque a pergunta “como ajustar melhor?” por “por que esse produto exige tanto ajuste?”. A resposta geralmente revela problemas de dado, de modelo ou de processo que têm solução quando tratados de forma estruturada.
Como o Calix atua aqui
Fazer essa análise uma vez resolve o diagnóstico. O desafio é rodar isso continuamente, com dados integrados e sem depender de esforço manual para manter o processo vivo.
O Calix foi construído exatamente para isso. A plataforma identifica automaticamente quais SKUs concentram o maior erro de previsão de demanda e conecta essa análise ao impacto financeiro real — estoque, margem, capital de giro. Tudo em uma única visão, atualizada em tempo real.
Os números mostram o resultado disso na prática: até 42% de redução no erro de previsão e até 39% de redução no estoque, com cases de clientes operando consistentemente acima de 80% de acurácia de forecast.
Além disso, a Susi, nossa agente de IA, responde perguntas diretas sobre o impacto financeiro de cada cenário. Basta perguntar, e ela analisa, responde e explica, sem depender de relatórios manuais ou de cruzamentos manuais de tabela.
A gestão de forecast baseada em média já mostrou onde chega. O próximo passo é operar orientado por impacto, tendo o Calix como o ponto de partida. Não deixe SKUs problemáticos afetarem a sua operação. Fale com a nossa equipe.